Tu agente se quedó sin turnos. Tu sistema lo anota como error.
Un agente que se queda sin presupuesto y un agente que se equivoca terminan igual en tu terminal: código de salida 1.
Durante dos meses mi sistema los trató como el mismo caso, y está mal, porque piden respuestas opuestas: uno se reanuda, el otro se corrige.
Detrás de esa confusión hay un número que casi nadie calibra y todo el mundo deja como viene: cuántos turnos dejarle al agente antes de cortarlo. Sin límite, se puede pasar horas dando vueltas sobre algo que no va a resolver. Con el límite muy bajo, abandona trabajo que estaba a dos pasos de terminar.
Ese número no se adivina. Recién en agosto, con 30 días de corridas reales en la base, pude armar una tabla de presupuestos por tipo de tarea en lugar de usar el mismo para todo.
Cómo era antes: sin límite y con un martillo
Al principio no había ningún tope de turnos. Cada paso corría con la configuración global por defecto y el único freno era un watchdog que mata procesos colgados después de una hora.
Un watchdog por tiempo es un instrumento romo. No distingue entre un agente que está trabajando bien en algo difícil y uno que entró en un bucle improductivo: los dos consumen una hora igual. Lo único que garantiza es que nada quede corriendo para siempre.
Ese watchdog, además, tuvo su propio aprendizaje operativo, del que hablo en la última entrega: la máquina se suspende de noche, así que había que descontarle el tiempo de suspensión al cálculo. Si no, mataba corridas sanas por horas que nunca habían transcurrido.
En junio agregué un tope de turnos global, como red de contención contra corridas desbocadas. Mejor que nada, pero seguía siendo un número único para tareas muy distintas entre sí.
La tabla que salió de los datos
En agosto el tope pasó a ser por tipo de tarea, calibrado mirando cómo se habían comportado realmente los últimos 30 días de corridas.
Lo que me gustó del resultado es que la tabla tiene una lógica que se puede explicar sin mirar los números:
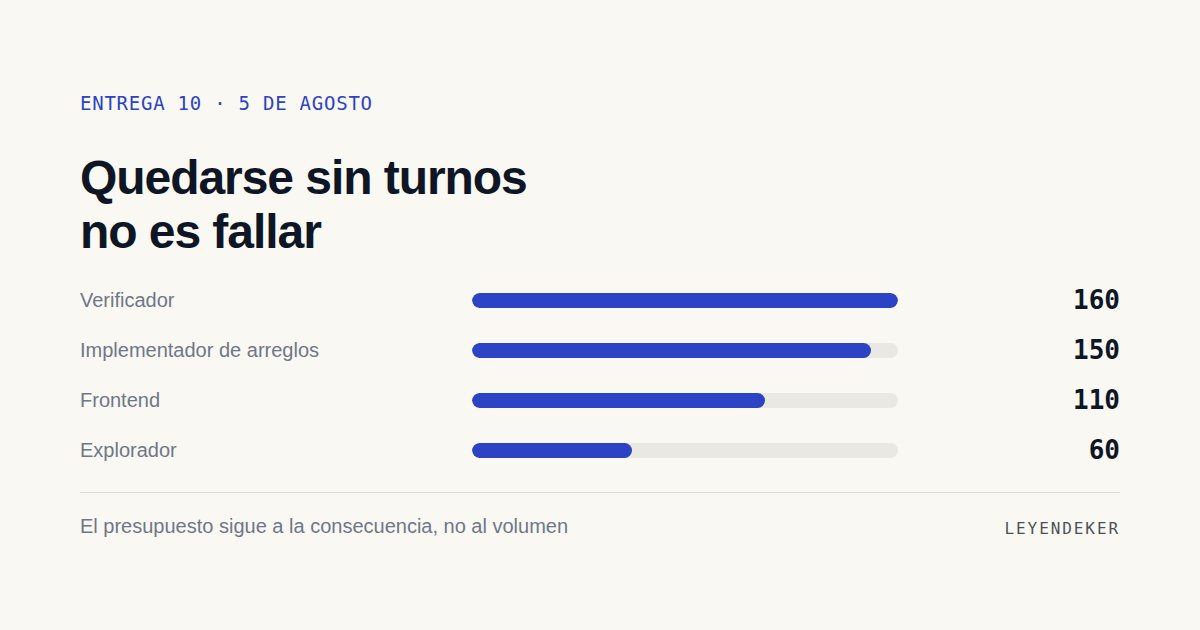
- El verificador es el más generoso, con 160 turnos. Tiene sentido: es el que revisa trabajo ajeno, y revisar bien implica leer mucho más de lo que uno escribe.
- El implementador de arreglos le sigue, con 150. Un arreglo suele arrancar sin saber dónde está el problema, así que buena parte del presupuesto se va en encontrarlo.
- Los implementadores de frontend rondan los 90 a 110, según si trabajan sobre la aplicación de administración o la pública.
- El explorador se queda con 60. Solo tiene que mapear el terreno y devolver los puntos de contacto: si necesita más que eso, algo está mal planteado.
Sobre todo eso hay un techo global de seguridad de 200 turnos, que ninguna tarea debería alcanzar y está ahí por las dudas.
El error que tardé dos meses en entender
Y ahora la parte que considero más importante de esta entrega, porque no es sobre el número sino sobre qué significa agotarlo.
Durante los primeros dos meses, un agente que se quedaba sin turnos aparecía en el sistema como "código 1". Es decir: exactamente igual que cualquier otro error.
Eso es un problema serio de diagnóstico. Quedarse sin presupuesto y fallar son dos cosas completamente distintas:
- Un fallo real significa que algo salió mal y hay que investigar qué.
- Agotar el presupuesto significa que el trabajo estaba en curso y se lo interrumpió. No hay nada roto: hay algo inconcluso.
Confundirlos me llevó a buscar bugs donde no había ninguno, más de una vez. Y a lo inverso, que es peor: a asumir que ciertos fallos eran "el límite de turnos otra vez" cuando en realidad eran errores legítimos.
En agosto lo separé. Ahora agotar el presupuesto tiene su propio mensaje, dice claramente qué pasó, y ya no mata la secuencia: el paso vuelve a la cola en vez de arrastrar toda la tarea al fracaso. Que es lo correcto, porque el trabajo hecho hasta ahí sigue estando.
Los presupuestos se editan sin tocar código
Una decisión chica con impacto grande: los topes por tarea son editables desde la interfaz, sin reiniciar nada.
La razón es que calibrarlos no es un trabajo que se hace una vez. Cambia el modelo, cambia la complejidad de los proyectos, cambian las habilidades. Un número que se ajusta editando código y redesplegando es un número que en la práctica nunca se ajusta.
El mismo criterio, aplicado al modelo
Hay una decisión emparentada que tomé al mismo tiempo y que tiene la misma forma: no todos los pasos merecen el mismo modelo.
El verificador —que es el paso más caro del sistema, ese 29% de la factura del que hablé en la entrega sobre la medición— corre deliberadamente con un modelo más barato. Verifica contra criterios explícitos, y para eso no hace falta el modelo más capaz disponible.
En cambio, el componente que toma decisiones autónomas sobre qué hacer a continuación corre en el tier más alto y con el máximo esfuerzo de razonamiento. Es el que menos veces se ejecuta y el que peor consecuencia tiene si se equivoca.
Es la misma idea que la de los turnos, aplicada a otra dimensión: el presupuesto tiene que seguir a la consecuencia, no al volumen.
Lo que aprendí
Un presupuesto de turnos parece un parámetro técnico y es una decisión de producto: define cuánta autonomía tiene cada tarea antes de que alguien la interrumpa.
Y el error más caro no es ponerle el número mal — eso se corrige con datos, y los datos aparecen solos si estás midiendo. El error caro es no distinguir "se quedó sin presupuesto" de "falló", porque lo primero se reanuda y lo segundo se investiga, y confundirlos te hace perder tiempo en las dos direcciones.
Lo que falta contar
Todo lo que conté hasta acá son decisiones de diseño: cosas que se piensan, se planifican y se implementan.
La última entrega es sobre la otra mitad del trabajo, la que no figura en ningún diagrama de arquitectura y se llevó la mitad del tiempo: todo lo que se rompe cuando dejás el sistema corriendo de verdad, durante meses, en una máquina que se suspende, se reinicia y se queda sin memoria.