Todo lo que se rompe cuando dejás de mirar la pantalla
Un agente que anda bien en una demo de diez minutos y uno que corre solo durante meses no son el mismo sistema. La diferencia no está en la arquitectura: está en decenas de casos borde que solo aparecen con tiempo de reloj encima.
Relojes desincronizados. Una máquina que se suspende de noche. Un parser que se rompe por un prefijo inesperado. Un navegador que crece sin techo hasta comerse la memoria. Una pregunta retórica, escrita por el propio agente, que trababa el pipeline entero esperando una respuesta que nadie iba a dar.
Ninguno de estos figura en un diagrama, y juntos se llevaron tanto tiempo como todas las decisiones de diseño anteriores. Si estás por dejar algo corriendo sin supervisión, esta es la lista que te gustaría haber leído antes.
Los relojes
Mi favorito, porque es el más difícil de sospechar. Durante un tiempo, una misma tarea podía leerse como viva o muerta según qué parte del sistema la mirara.
La causa: el nombre del archivo de registro se generaba con una zona horaria y el estado se evaluaba con otra. Ninguna de las dos estaba "mal" — simplemente eran distintas. El resultado era que una corrida perfectamente activa aparecía como detenida, o al revés, según la hora del día.
Los desfasajes de zona horaria son el tipo de bug que no se encuentra leyendo código, porque cada pieza por separado se ve razonable. Se encuentra mirando la pantalla y notando que dice una cosa mientras el sistema hace otra.
La máquina que se duerme
El watchdog mata procesos que llevan demasiado tiempo corriendo. Simple, hasta que la máquina se suspende de noche.
Cuando volvía, el watchdog calculaba el tiempo transcurrido en horas de reloj y encontraba procesos con ocho o diez horas de "actividad" que en realidad no habían ejecutado un solo ciclo. Y los mataba, con razón desde su punto de vista.
Hubo que enseñarle a descontar el tiempo de suspensión del host. Es un ajuste de tres líneas que solo se te ocurre después de perder trabajo por eso.
Los parsers frágiles
La barra de progreso de los tests end-to-end se quedaba congelada en cero. La suite corría bien, los tests pasaban, pero el indicador no se movía nunca.
El motivo: el corredor de tests incluye el nombre del proyecto en cada línea de salida cuando hay más de un proyecto configurado, y mi parser esperaba el formato sin ese prefijo. Una línea de más y el contador quedaba en cero para siempre.
Es un recordatorio de algo que subestimé mucho al principio: casi toda la integración con herramientas externas pasa por parsear su salida de texto, y esa salida cambia sin previo aviso, por configuración o por versión.
La memoria que crece sola
El navegador que corre las revisiones de interfaz crecía en memoria sin techo. No era una fuga en mi código: era el comportamiento normal de un navegador que se mantiene abierto durante horas, acumulando pestañas, contextos y caché.
La solución no fue elegante y no tenía por qué serlo: reciclar los contenedores cuando pasan cierto umbral de RAM. Los procesos de larga vida no se arreglan, se reinician periódicamente.
Los estados que mienten en la pantalla
Hubo una familia entera de bugs alrededor de la interfaz mostrando cosas que no eran.
Filas que giraban indefinidamente con un indicador de actividad, porque el identificador de la tarea activa se comparaba mal y ninguna coincidencia lo apagaba. Corridas vivas que se leían como detenidas. Pasos que no hacían nada pero se apropiaban del botón de ejecución.
Todos son cosméticos en apariencia y ninguno lo es en la práctica, porque el estado que muestra la pantalla es lo que usás para decidir si intervenir. Un indicador que miente te hace esperar por algo que ya terminó, o interrumpir algo que estaba trabajando bien.
Las operaciones que no distinguen el vacío
Los pasos de solo lectura —los que exploran el código sin modificar nada— disparaban igual el push automático al terminar. Como no había nada para subir, la operación fallaba, y ese fallo se reportaba como si la tarea hubiera salido mal.
Es el mismo patrón que el de los turnos agotados de la entrega anterior: el sistema no distinguía "no había nada que hacer" de "algo salió mal". Y esa confusión genera ruido que después te lleva a ignorar los avisos, que es la peor consecuencia posible.
La pregunta retórica que trababa todo
Una habilidad terminaba sus corridas con una pregunta del tipo "¿seguimos con la siguiente parte?". No esperaba respuesta: era una fórmula de cierre.
Pero el orquestador detecta las corridas que quedan esperando input del usuario, para no dejarlas colgadas indefinidamente. Una pregunta al final, aunque sea retórica, activa esa detección y aborta la secuencia entera.
La solución fue prohibir explícitamente cerrar con una pregunta. Y es también el caso que originó el loop de auto-mejora del que hablé en la cuarta entrega: fue el ejemplo canónico de "esto lo detecté yo a mano, debería detectarlo el sistema".
La infraestructura ajena que se cae
Cuando la API del proveedor devolvía un error de servidor, la cola entera se frenaba. Una intermitencia de treinta segundos dejaba parado el trabajo de la tarde.
Ahora esos errores reintentan el paso en vez de matar la secuencia. Es la misma idea que aparece en la entrega sobre política de fallos: hay que separar los fallos del trabajo de los fallos del entorno, porque se responden distinto.
El patrón detrás de todos
Mirando la lista completa, la mitad de estos casos no se descubrieron leyendo código. Se descubrieron mirando la pantalla y notando que algo decía una cosa mientras el sistema hacía otra.
Y casi ninguno es un problema de agentes. Son problemas viejos de sistemas distribuidos: relojes desincronizados, timeouts mal calculados, procesos de larga vida que acumulan estado, parsers frágiles, dependencias externas que fallan. Reaparecen intactos porque un agente corriendo durante horas es, para todo efecto práctico, un proceso de larga vida no confiable.
Si tuviera que dar un solo consejo a alguien que está por construir algo así, sería este: la parte interesante —los prompts, la arquitectura, la política de reintentos— es la que vas a resolver rápido. La parte que se lleva el tiempo es la que hace que el sistema siga siendo verdad cuando nadie lo está mirando.
El arco completo
Ese es el recorrido de estos cuatro meses. Empezó siendo una pantalla con botones para lanzar agentes, con dos commits dedicados al ícono de un botón, y terminó siendo un sistema de control con desconfianza, presupuesto y auditoría.
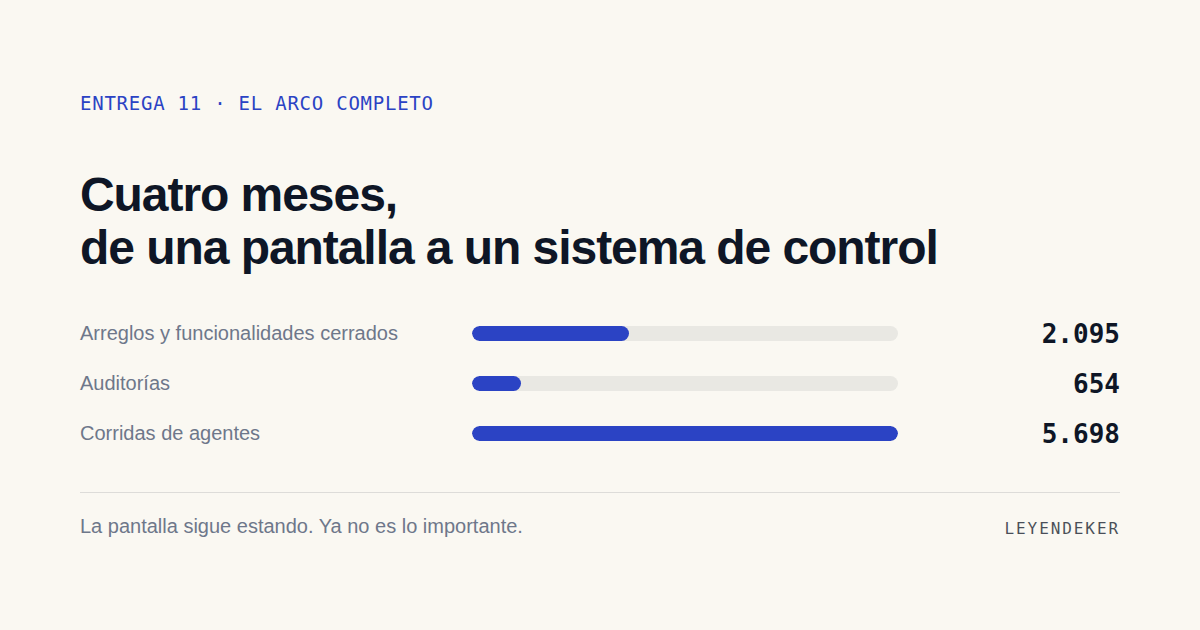
Hoy lleva 2.095 arreglos y funcionalidades cerrados, y 654 auditorías, sobre proyectos reales.
La pantalla sigue estando. Ya no es lo importante.