Le pedí a la IA que corrigiera sus propias instrucciones: 1.771 incidentes, 13 propuestas
Si trabajás con agentes, esta idea seguro se te cruzó: si el sistema registra sus propias fallas, debería poder leer los patrones y proponer arreglos a sus propias instrucciones. Se mejora solo, con vos aprobando cada cambio antes de que se aplique.
La construí entera, con la aprobación humana incluida desde el día uno. Funciona. Junté 1.771 incidentes en tres meses y salieron 13 propuestas.
Y el sistema prácticamente no mejoró por esa vía. No falló por donde uno esperaría —ni el modelo ni el paso de aprobación fueron el problema— y esa es la parte que vale la pena contar, porque el error está en el nivel de diseño y se repite en cualquier sistema que intente aprender de sus propios registros.
El caso que originó la idea
No fue una idea abstracta: salió de un problema concreto y repetido.
Una de las habilidades del sistema tenía la costumbre de terminar sus corridas con una pregunta. Algo del estilo "¿querés que continúe con la siguiente parte?". Para el orquestador, una corrida que termina esperando input es una corrida trabada: abortaba la secuencia entera.
Lo arreglé a mano, editando las instrucciones de esa habilidad. Y mientras lo hacía pensé lo obvio: este patrón está registrado. El sistema sabe que esta habilidad falló por este motivo, varias veces. ¿Por qué tengo que ser yo el que lo detecte?
El objetivo quedó escrito así: reemplazar el ciclo humano detecta, humano edita, humano commitea por el sistema detecta, propone un parche, el humano aprueba con un click.
La restricción que puse desde el día uno
Antes de escribir una línea, decidí algo que hoy sigo considerando la mejor decisión de todo el subsistema: la rutina nunca edita archivos ni commitea por su cuenta.
Su salida no es un cambio, es una propuesta: el diff más el razonamiento de por qué. Se guarda en la base de datos y espera. Un humano la aprueba y ahí sí se aplica, o la rechaza y queda archivada.
La tentación de saltearse eso es fuerte, porque la aprobación manual es justamente el cuello de botella que querés eliminar. Pero un sistema que modifica sus propias instrucciones sin supervisión no tiene ningún freno: si el criterio con el que evalúa está mal, cada iteración lo empeora, y no hay nada afuera que lo detecte.
Cuatro fases, todas implementadas
El diseño quedó en cuatro partes, y las cuatro están funcionando:
- Una tabla unificada de incidentes, que consolida señales que antes vivían desperdigadas: rendiciones del orquestador, habilidades que se traban esperando input, chequeos previos que fallan.
- Una detección de patrones recurrentes: agrupa por habilidad y motivo, y marca los que aparecen tres veces o más en siete días.
- La rutina que propone el parche, que decide si el arreglo va en las instrucciones de la habilidad o en el código, calcula el diff y lo persiste.
- La interfaz de aprobación, con un límite de 24 horas para no reproponer lo mismo una y otra vez.
Nada de esto está roto. Todo corre.
Los números, tres meses después
Cuando fui a medir el resultado, esto es lo que encontré:
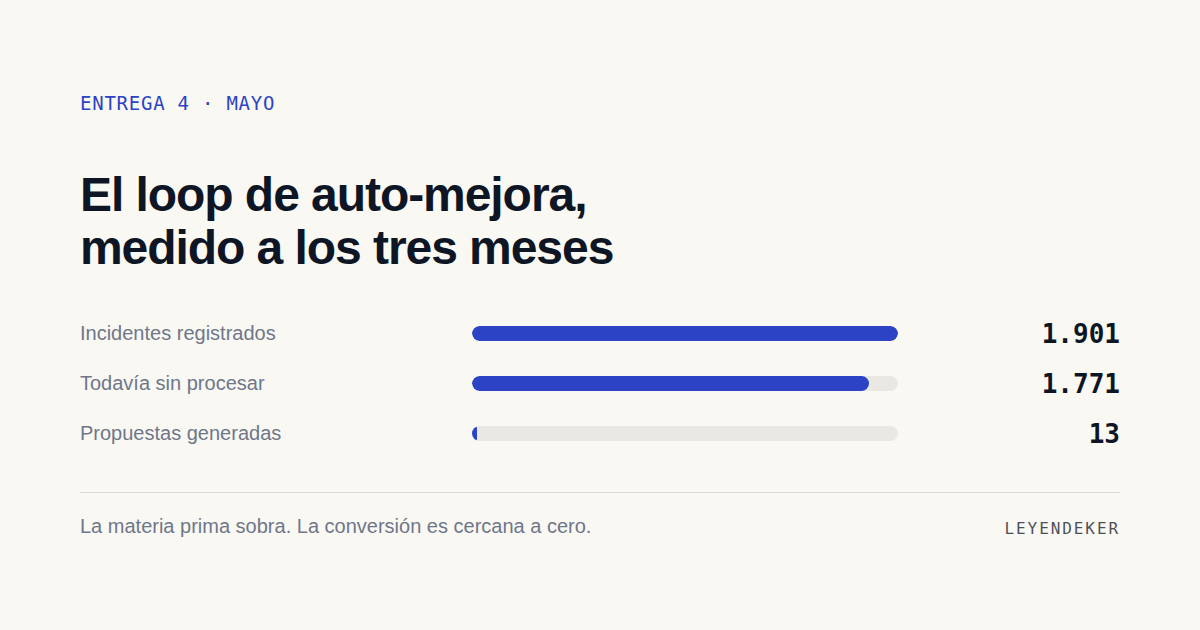
- 1.901 incidentes registrados en total.
- 1.771 de ellos todavía abiertos, sin procesar.
- 13 propuestas generadas en toda la historia del sistema. Siete aprobadas, seis rechazadas.
Trece. En tres meses, con casi dos mil incidentes de materia prima.
Y lo que más molesta es que los incidentes más frecuentes son exactamente los que uno querría convertir en reglas. En catorce días: 351 lecturas repetidas del mismo archivo, 154 búsquedas que no encontraron nada y 151 comandos fallidos. Todos patrones accionables. Todos ahí, sin procesar.
Dónde falló, que no es donde uno esperaría
Mi primera reacción fue pensar que el modelo no estaba a la altura de la tarea. Es la explicación cómoda, y estaba equivocada.
El loop no falla en la parte inteligente. Falla en la cañería. Las hipótesis que tengo abiertas —y que todavía no terminé de descartar— son tres, y ninguna tiene que ver con la capacidad del modelo:
- Que la rutina de propuestas casi no se esté disparando, por cómo quedó programada su ejecución.
- Que la vista de patrones recurrentes no esté agrupando bien, y por eso no encuentre nada que reportar.
- Que el umbral de tres ocurrencias en siete días sea inalcanzable, no porque los patrones no se repitan, sino porque hay tanto ruido de fondo que los casos reales quedan diluidos.
Esa última hipótesis es la que más me interesa, porque implica que el problema no es de detección sino de calidad de la señal. Si el detector de ineficiencias genera falsos positivos a gran escala, no importa cuán bueno sea lo que venga después: le estás pidiendo que encuentre patrones en un montón de ruido.
Por eso el próximo paso no es mejorar la rutina que propone parches. Es hacer un triage de los 1.771 incidentes abiertos y responder algo más básico: cuántos son señal real y cuántos son ruido del propio detector. Si el grueso es ruido, hay que endurecer la detección antes de pedirle propuestas a nadie.
Lo que aprendí de esto
Un loop de auto-mejora no falla por falta de inteligencia. Falla en la cañería, que es la parte que nadie muestra en las demos.
Registrar señales es fácil y barato, y por eso es lo primero que uno construye. Se siente productivo: los números suben, la tabla se llena, parece que el sistema está aprendiendo. Convertir esa señal en acción es el trabajo real, y es exactamente donde el proyecto se detuvo.
Acumular 1.771 incidentes sin procesarlos no es telemetría. Es un log caro con aspecto de tablero.
La lección la aplico ahora antes de instrumentar cualquier cosa nueva: si no tengo claro qué decisión va a tomar alguien —o algo— con ese dato, la instrumentación puede esperar.
La segunda vez que los datos me contradijeron
Este fue el primer resultado que me obligó a ir a mirar la base de datos en vez de confiar en lo que creía que estaba pasando.
Un mes después hice lo mismo con el resto del sistema, en una revisión general con el objetivo de mejorar la velocidad del pipeline. Tenía un diagnóstico armado y un plan escrito en base a él.
Los datos me hicieron tirar ese plan el mismo día. De eso trata la próxima entrega.